1745 字
9 分钟
MianCoach · AI 面试陪练
项目简介
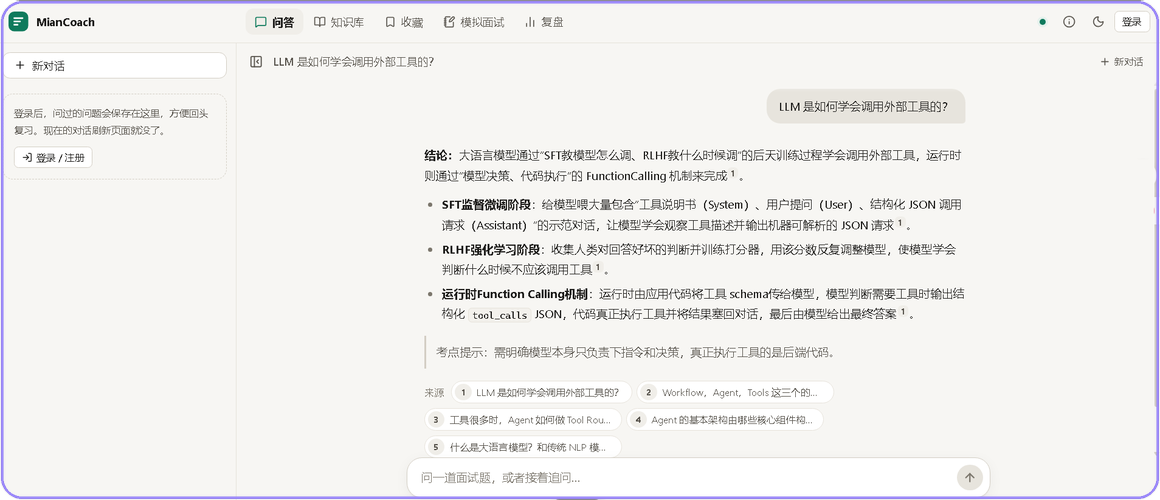
MianCoach 是一个基于检索增强生成(RAG)的技术面试陪练应用,将知识库问答、题目收藏、模拟面试和练习复盘整合在同一套题库中。系统从题库原文检索参考资料,生成带来源引用的回答,并根据标准资料提供作答反馈。
🌐 在线体验:prep.eriiagi.com
核心功能:
- 💬 知识库问答:支持流式回答、来源引用和多轮追问,可打开引用核对原文
- 📚 题库浏览:按板块、类目浏览题目,支持搜索高亮、题目定位和原文图片查看
- ⭐ 个人收藏:从知识库或问答来源原文收藏整道题,按用户隔离,支持板块筛选和分页复习
- 🎯 模拟面试:按范围抽题,对照题库原文批改,展示得分、命中的知识点与补充建议
- 📊 面试复盘:历史记录和面试场次,带 AI 总结,可回放对话
技术架构
后端技术栈
- 核心框架:Spring Boot 3.3.5
- 数据库:PostgreSQL 17 + pgvector 0.8
- AI 集成:
- 生成:阿里云百炼
qwen-plus - 向量化:硅基流动
BAAI/bge-m3 - 重排:
BAAI/bge-reranker-v2-m3
- 生成:阿里云百炼
- 部署:Docker Compose
前端技术栈
- 框架:Vue 3.5 + TypeScript
- 构建:Vite 6
- UI 库:Element Plus
- 状态管理:Pinia
功能详解
1. RAG 知识问答
系统采用 Parent-Child 分块策略:
- 检索粒度:小块(child chunk),提升召回精度
- 回答上下文:大块(parent chunk),保留完整语义
- 多路召回:向量检索 + BM25 混合召回,pgvector 负责向量相似度计算
RAG 流程:
- 用户提问经过意图分类(安全审查、拒答)
- 查询向量化,从 PostgreSQL 检索 Top-K 候选
- Reranker 对候选重排,筛选最相关片段
- 组装上下文,调用大模型流式生成
- 答案带来源引用,点击可查看原文
关键实现:
- 使用 pgvector 的 HNSW 索引加速向量检索
- 支持多轮对话,前端传递最近一轮历史
- 游客模式不保存对话,登录用户按会话隔离
2. 模拟面试与批改
面试流程:
- 选择范围(板块 + 类目),设置抽题数量
- 系统随机抽题,用户依次作答
- AI 对照题库原文批改,给出:
- 得分(0-100)
- 命中的知识点
- 补充建议
- 面试结束后生成场次总结,可回放对话
批改提示词设计:
- 使用题库原文作为标准答案
- 要求 AI 明确指出遗漏的关键点
- 给出具体的补充建议,不只是泛泛的鼓励
3. 题库与收藏
题库组织:
- 板块(如 Agent、RAG、工具调用)
- 类目(二级分类)
- 题目(Markdown 格式,包含代码、图片)
收藏功能:
- 从问答的来源引用直接收藏
- 从题库浏览页收藏
- 按板块筛选,分页复习
- 用户数据隔离,支持删除
技术亮点
1. pgvector 向量检索优化
-- HNSW 索引创建CREATE INDEX chunks_embedding_hnsw_idxON chunks USING hnsw (embedding vector_cosine_ops)WITH (m = 16, ef_construction = 64);
-- 向量相似度查询(余弦距离)SELECT parent_id, content, 1 - (embedding <=> $1) AS scoreFROM chunksWHERE board_id = ANY($2)ORDER BY embedding <=> $1LIMIT 20;优化策略:
- 使用 HNSW(Hierarchical Navigable Small World)索引,查询速度快
m=16, ef_construction=64平衡了索引构建速度和查询精度- 板块过滤在向量检索前执行,减少计算量
2. 流式回答与引用
后端使用 SseEmitter 流式推送:
- 答案逐 token 流式输出,降低首字延迟
- 引用信息在流结束后单独推送
- 前端按行解析 SSE,实时渲染 Markdown
3. 多模型配置与降级
系统支持三个独立的模型端点:
chat:生成端(问答、批改、总结)embed:向量端(语料向量化、查询向量化)rerank:重排端(召回候选打分)
降级策略:
- Rerank 失败时降级为向量检索排序
- 向量化失败时返回空结果,不阻断用户操作
- 生成失败时返回错误提示,不影响历史记录
4. 安全与权限
- JWT 认证:HS256 签名,1 天过期
- 密码加密:BCrypt,防止彩虹表攻击
- 数据隔离:会话、收藏按
user_id隔离,API 校验归属 - 管理员保护:禁止删除自己、禁用自己或取消自己的管理员角色
部署运行
本地开发
# 1. 启动后端(需要 PostgreSQL + pgvector)cd server./mvnw spring-boot:run
# 2. 启动前端cd webpnpm installpnpm devDocker Compose 部署
# 生产环境(PostgreSQL + 后端 + 前端 Nginx)docker compose -f compose.prod.yml up -d
# 查看日志docker compose -f compose.prod.yml logs -f server环境变量配置:
AI_CHAT_*:生成模型配置(API Key、Base URL、模型名)AI_EMBED_*:向量模型配置AI_RERANK_*:重排模型配置JWT_SECRET:JWT 签名密钥(生产必须修改)POSTGRES_*:数据库连接信息
详细配置见 .env.example。
开发心得
1. RAG 不是银弹
RAG 能减少幻觉,但不能完全消除:
- 检索召回不准时,答案仍会偏离
- 题库内容质量直接影响回答质量
- 需要持续优化分块策略和检索参数
经验:
- Parent-Child 分块比固定窗口效果好
- 混合检索(向量 + BM25)召回更全
- Rerank 对提升精度帮助很大,但有额外成本
2. 向量索引的权衡
HNSW 索引构建慢但查询快,适合读多写少的场景。我的题库约 2000 个 chunk,索引构建耗时约 10 秒,但查询只需几毫秒。
踩过的坑:
- 初次部署时忘记建索引,查询超时
ef_construction设太大(200+),索引构建卡死- 调整为
m=16, ef_construction=64后平衡了性能
3. 流式回答的坑
SSE 在生产环境可能被 Nginx、CDN 缓冲,导致前端收不到实时数据。
解决方案:
- Nginx 配置
proxy_buffering off; - 每条消息以
\n\n结尾,符合 SSE 规范 - 前端使用
EventSource或fetch读取流
4. 用户体验细节
- 游客模式:不登录也能问答,降低试用门槛
- 引用可点击:直接查看原文,增强可信度
- 暗色模式:长时间复习不刺眼
- 响应式设计:移动端也能流畅使用
未来规划
- 支持更多向量模型(OpenAI、本地模型)
- 增加语音面试功能(语音识别 + 实时批改)
- 面试题库自动扩充(爬虫 + 去重)
- 导出复习笔记(PDF、Markdown)
- 跨模型对比(A/B Test 不同大模型的批改质量)
项目地址
- 🔗 GitHub: elaina-agi/miancoach
- 🌐 在线体验: miancoach.elaina.icu
如果这个项目对你有帮助,欢迎 Star ⭐ 和提 Issue!
MianCoach · AI 面试陪练
https://blog.eriiagi.com/posts/miancoach/分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
最后更新于 ,距今已过 1 天
部分内容可能已过时
评论